AI 语音生成器的原理
每个音色都是模型从录音中学到的一种说话人特征。生成时,模型用这个声音为你的文字说出全新的语音,并根据字词和标点决定节奏和语调。所以同一个音色既能播新闻,也能讲睡前故事。
变声器是把你自己的录音变成另一种声音;而基于文字的 AI 语音生成器不需要麦克风:你打字,它说话。
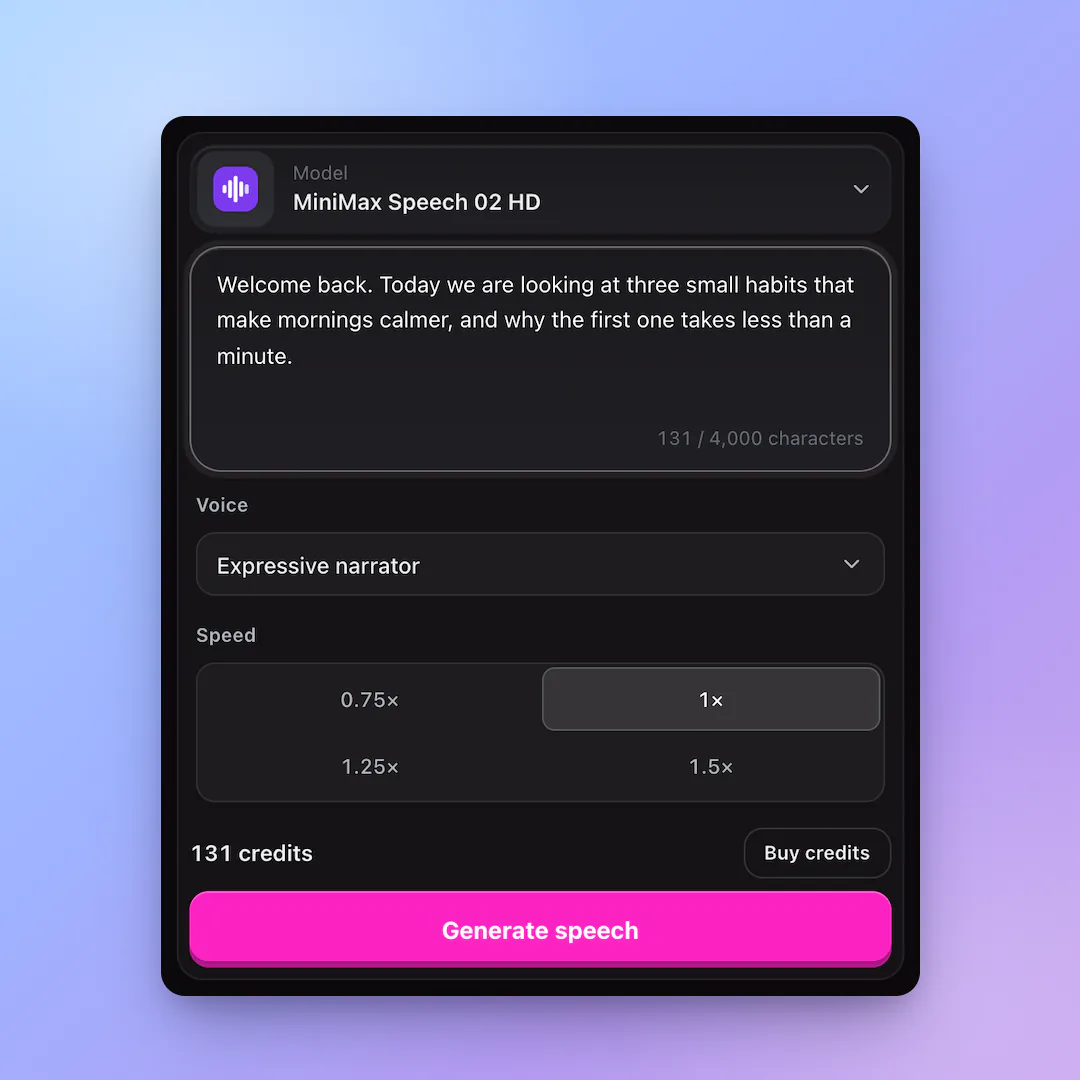
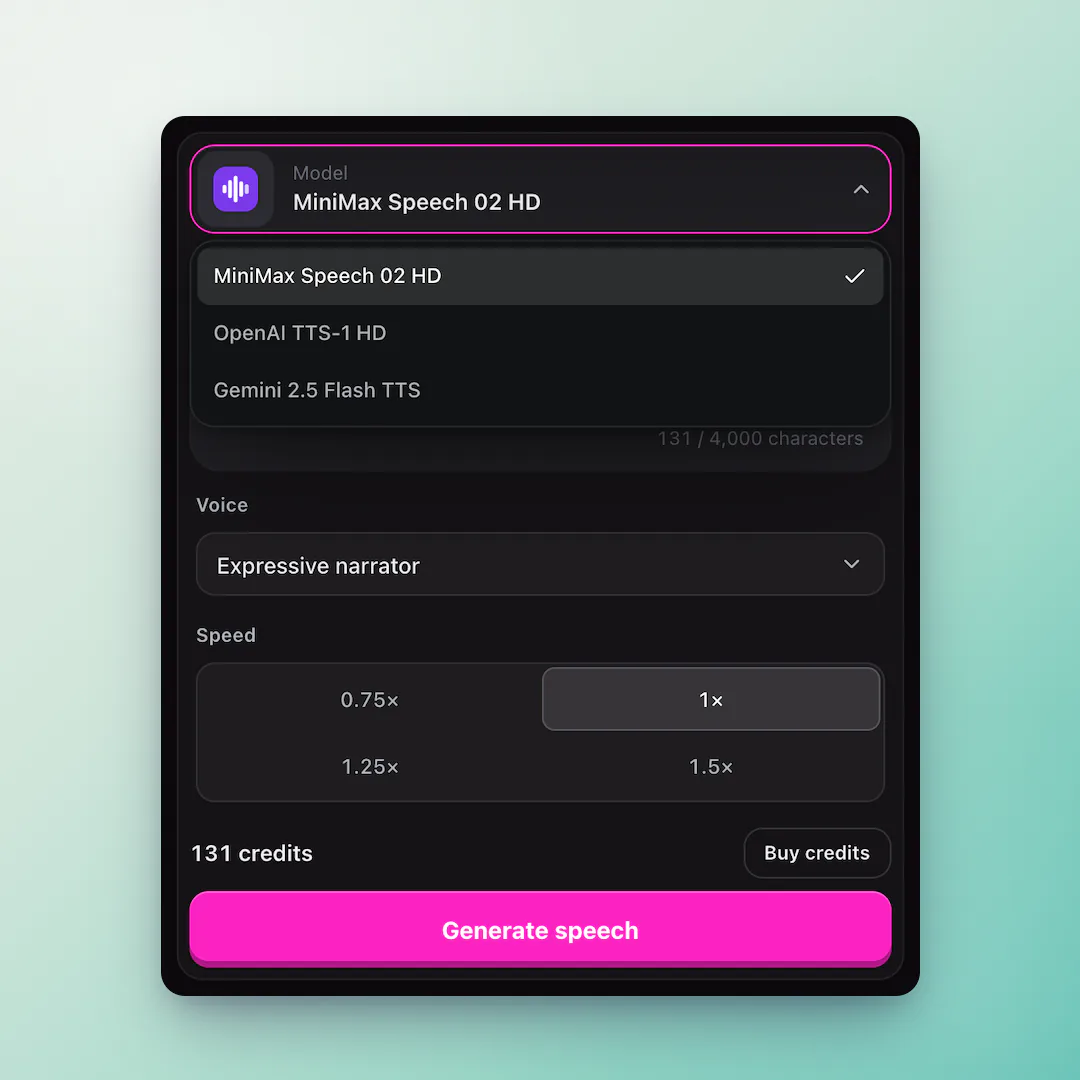
这个 AI 语音生成器可以用 61 种合成音色朗读你的文字:ElevenLabs 的 22 种音色包括Callum — 张力十足的角色这样张力十足的角色、Charlotte — 魅惑角色这样魅惑的角色,以及Aria — 富有表现力和Jessica — 活泼随和这样活泼随和的声音,另有 OpenAI 的 9 种和 Gemini 的 30 种音色——Gemini 还能听懂写在正文前面的语气提示,比如“Say dramatically:”。每句按每字符 1 积分(Gemini 2 积分)计费。所有音色都是合成角色,不会模仿任何真实人物。
沉稳、可信、富有表现力的声音,适合讲解视频、网课和纪录片。
英雄、女王、反派、喜剧演员,适合游戏、动画和故事。用Callum — 张力十足的角色演绎张力十足的台词,用Charlotte — 魅惑角色演绎魅惑角色。
Gemini 的音色能读懂写在正文前面的语气提示,例如“Say warmly:”或“Say dramatically:”,不需要额外的效果插件就能调整情绪。
ElevenLabs 的每一种音色都覆盖 29 种语言,同一个声音就能读完西班牙语、日语等不同语言的台词。
按实际要说的样子写,用标点控制停顿和语气。
音色列表里,ElevenLabs 的音色按口音分组,比如“跨大西洋口音”里的 Callum、“瑞典口音”里的 Charlotte。
同一句台词用两三个音色各生成一次;短句只花几个积分。
每个音色都是模型从录音中学到的一种说话人特征。生成时,模型用这个声音为你的文字说出全新的语音,并根据字词和标点决定节奏和语调。所以同一个音色既能播新闻,也能讲睡前故事。
变声器是把你自己的录音变成另一种声音;而基于文字的 AI 语音生成器不需要麦克风:你打字,它说话。
Gemini 3.8 Flash TTS 没有语速调节,但能读懂写在正文前面的一句简短提示,比如“Say warmly:”“Say dramatically:”或“Say in a flat, robotic tone:”,让同一段文字读出不同的情绪,而不用后期剪辑加效果。想要更冷峻、机械感更强的朗读,也可以先用这种提示试试,再决定要不要在剪辑软件里叠加效果器。
这里没有声音克隆,任何音色都不模仿真实人物。不得用任何音色冒充真实人物说话、欺骗听众或骚扰他人;这违反我们的条款,违规账号会被关闭。
注册免费,生成语音需要购买积分,没有注册赠送额度。每字符 1 积分(Gemini 2 积分),每 1,000 字符 0.06–0.10 美元。
没有专门做成那种音色,但可以用 Gemini 的语气提示让声音更冷峻、更平板,比如在正文前写“Say in a flat, emotionless tone:”,再在剪辑软件里叠加效果器增强金属感。
不能。网站只提供各模型服务商内置的合成音色,不允许模仿真实人物,包括公众人物。
可以,用于视频、播客、广告、课程和应用都行,但需遵守我们的条款和所用模型的使用政策。最重要的两条:不要把合成声音冒充成某个真实人物的声音;如果发布用 OpenAI 音色生成的音频,OpenAI 要求告知听众这是 AI 生成的声音。我们无法保证某个音色只归你使用,其他用户也能使用同样的音色。
最后更新:2026年10月18日